关于武汉新型肺炎的一些数学模型及预测
目录
一.英国伦敦帝国理工的报告
关于发生在武汉的新型肺炎情况,到目前为止,英国伦敦帝国理工(Imperial College)一共发布了两份关于早期感染人数的报告。一份是在一月十七日发布的,一份是在一月22日发布的。都是基于通过样本估计总体的思想,主要通过航空数据和境外感染的各例对整个武汉感染人数做出估计。
官方报告提高计算方法的英文版:
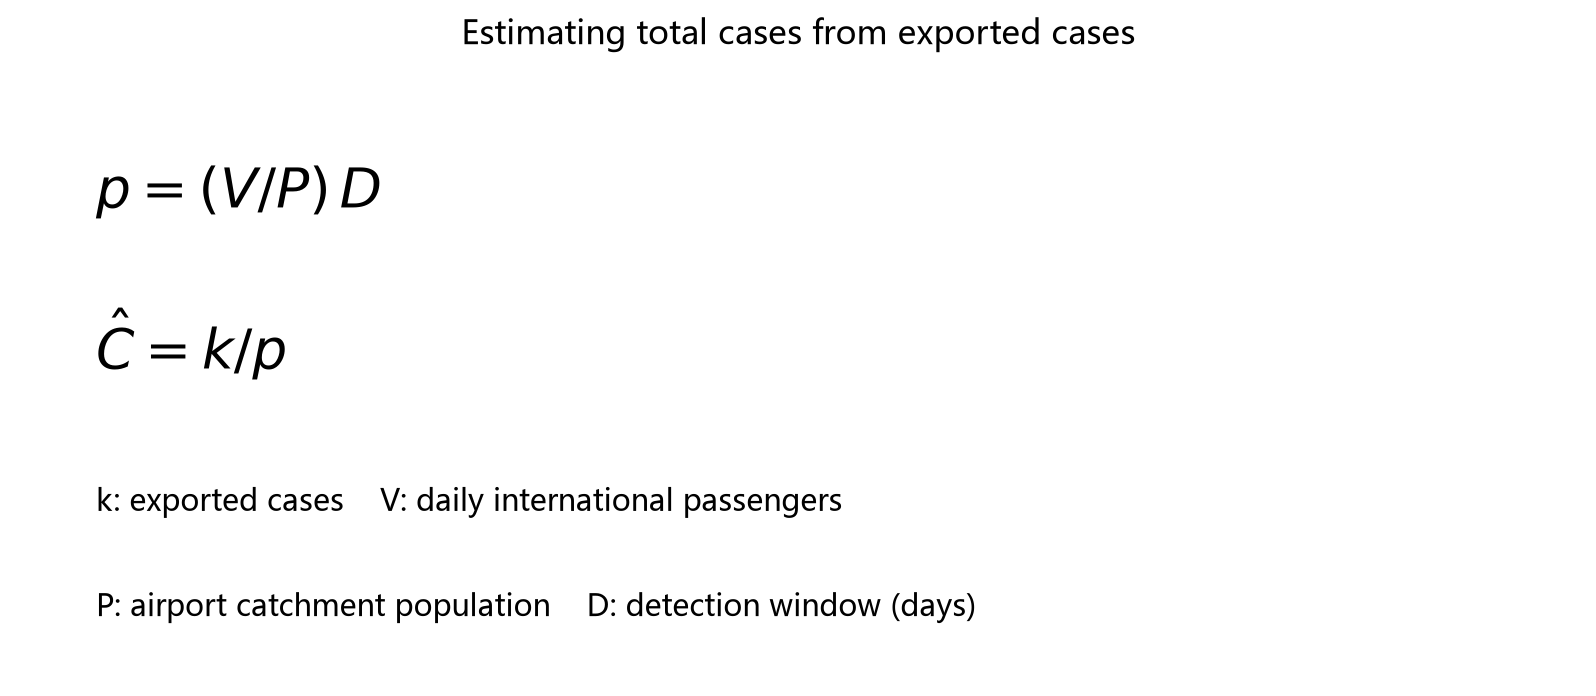
在第二份报告中,英国伦敦理工大学还在第二份报告中提供了对应的普通话翻译,下面截取的是关于计算方法的部分。
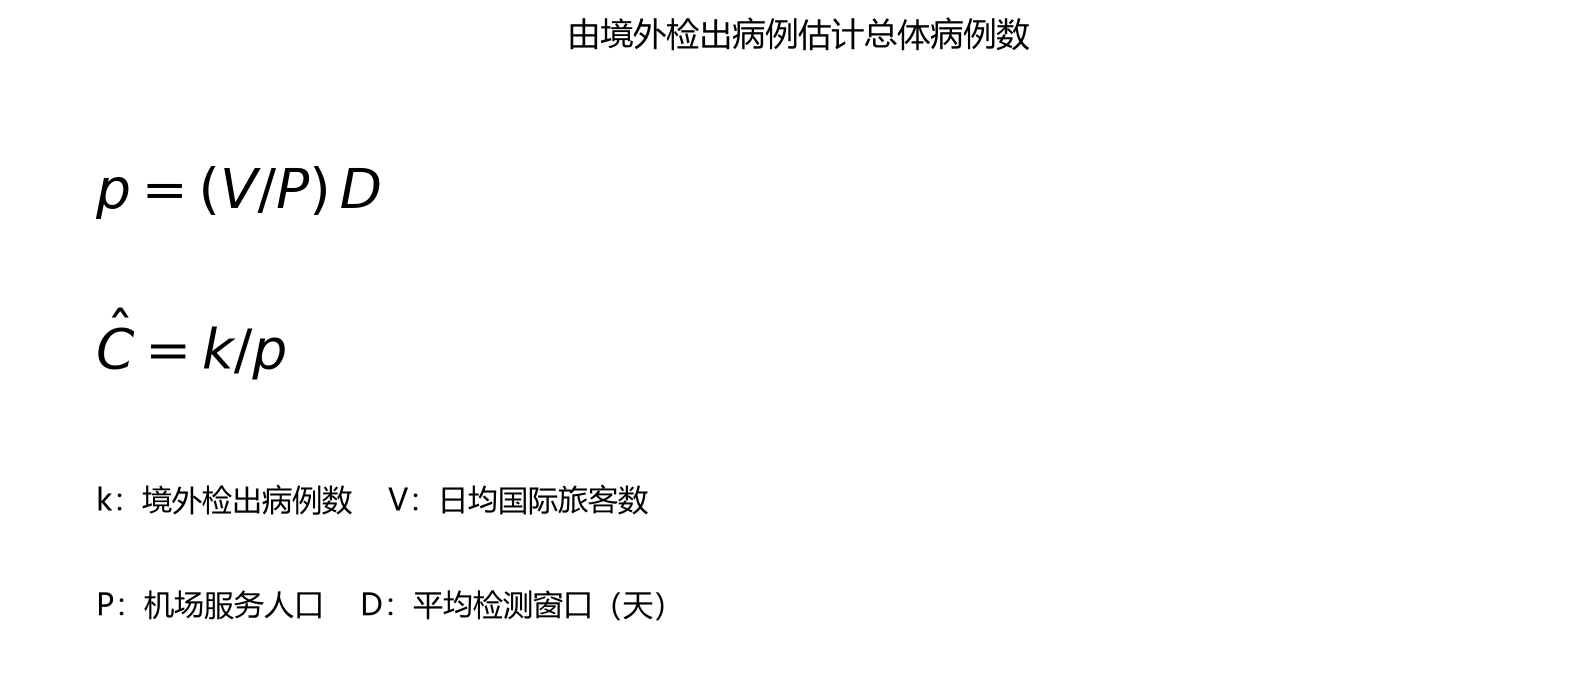
中文翻译总体上来说还是比较正确的,但有一处地方却不小心翻译错了,就在关于p计算的地方:中文翻译是p = 每日国际旅行的概率 x 平均检测除一例病例的概率,而根据英文,及模型实际的含义推测,平均检测除一例病例的概率实际应为平均检出时间**,即为表格中的检测窗口时间(Detection window(days)。
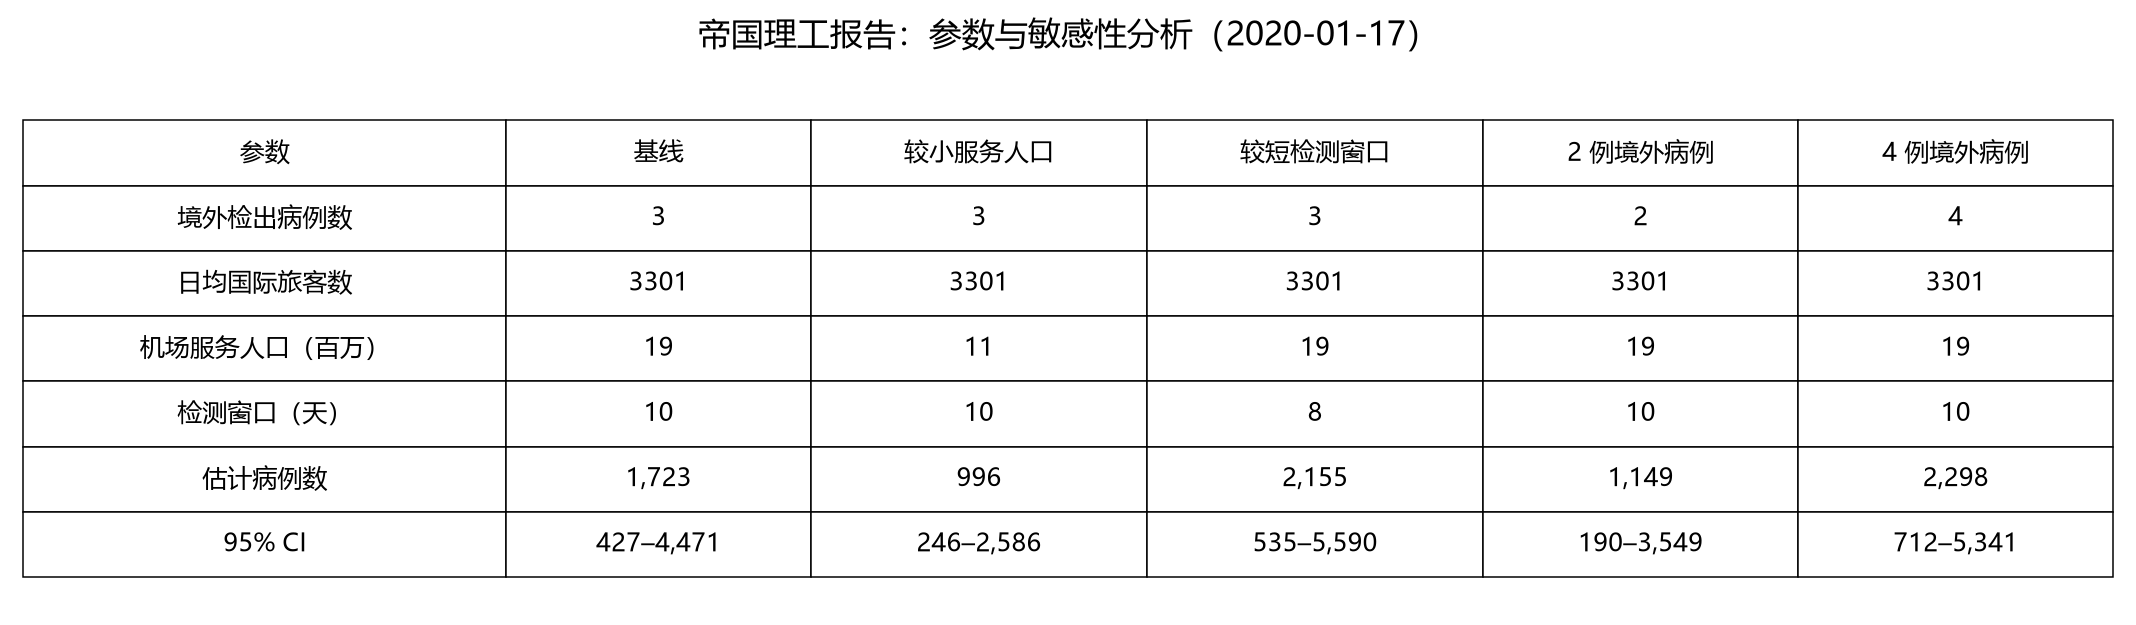
报告一是利用的截至1月16日的数据。以Baseline为例,估计感染的总数=3/( (3301 / 1.9e7) * 10) ,约为1727,至于英国理工大学官方为什么取的是1723,我也不太清楚,但整体的计算方法应该不会有错,结果也差不多。
报告二是采用的截至1月18日的数据。国外确诊病例增加到了7例,其它的计算方法不变,参数也不变,因而估计感染的总数为7/((3301 / 1.9e7) * 10),约为4029.
此外两份报告还对确诊人数,和武汉国际机场有效服务的人数进行了敏感性分析,及计算了95%置信区间的估计病例可能波动的范围。
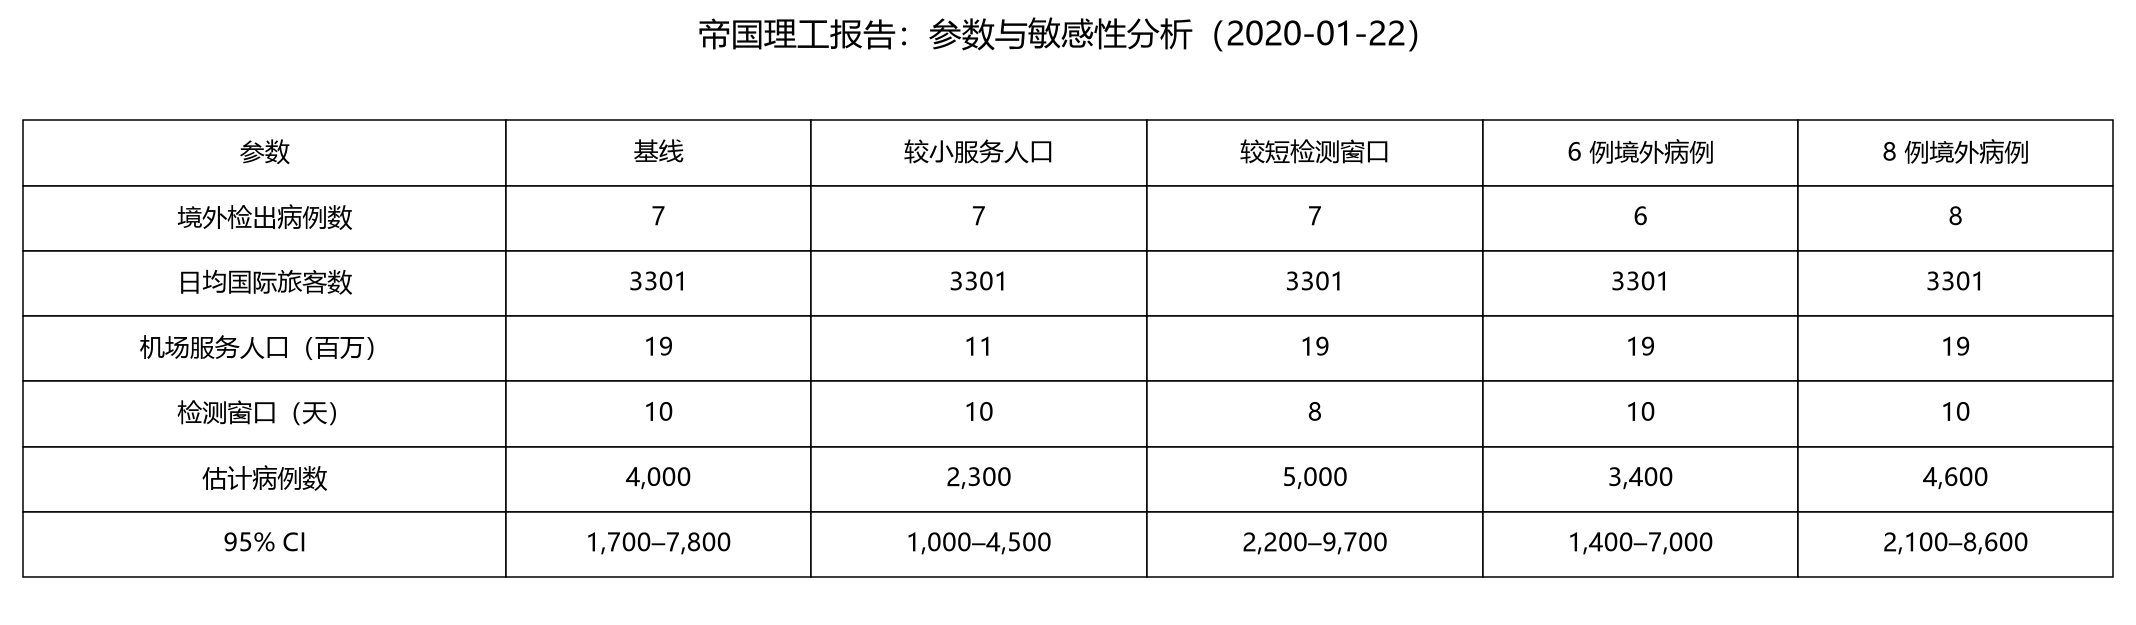
英国理工大学第二份报告是在1月22日报告发出,而我写这篇文章的时间是1月17日。已经有了更多的情报可以知道,一个是关于检测窗口时间的情报,报告中的检测窗口时间=潜伏期 + 确诊时间。而报告估计的潜伏期为5~6天,而现在(1/27)确定的潜伏期时间平均为10天,最长为14天。这个数值的变化会使最终的结果变小。第二个就是关于武汉机场实际服务的人口的1100万~1900万,最新新闻提到武汉在在封城前有500万人左右离开武汉,900万人留在武汉。加起来就是1400万人左右。在1100万~1900万的范围内。
就个人而言,我觉得这个报告的结果(早期传染者为1700~7800)还是可信的,因为模型的计算思路还是合理且正确的(还有一点我没有深入研究,就是关于可信区间的计算,我还没有亲自验证),当然整个模型是建立在一些假设的基础上的(报告中有提,假设基本合理或对最终结果影响不大)。
SIR模型
除了上述英国理工的数学模型,我还在媒体上看到的另一个模型就是SIR模型,一个基于微分方程的传染病模型。具体内容见下图:
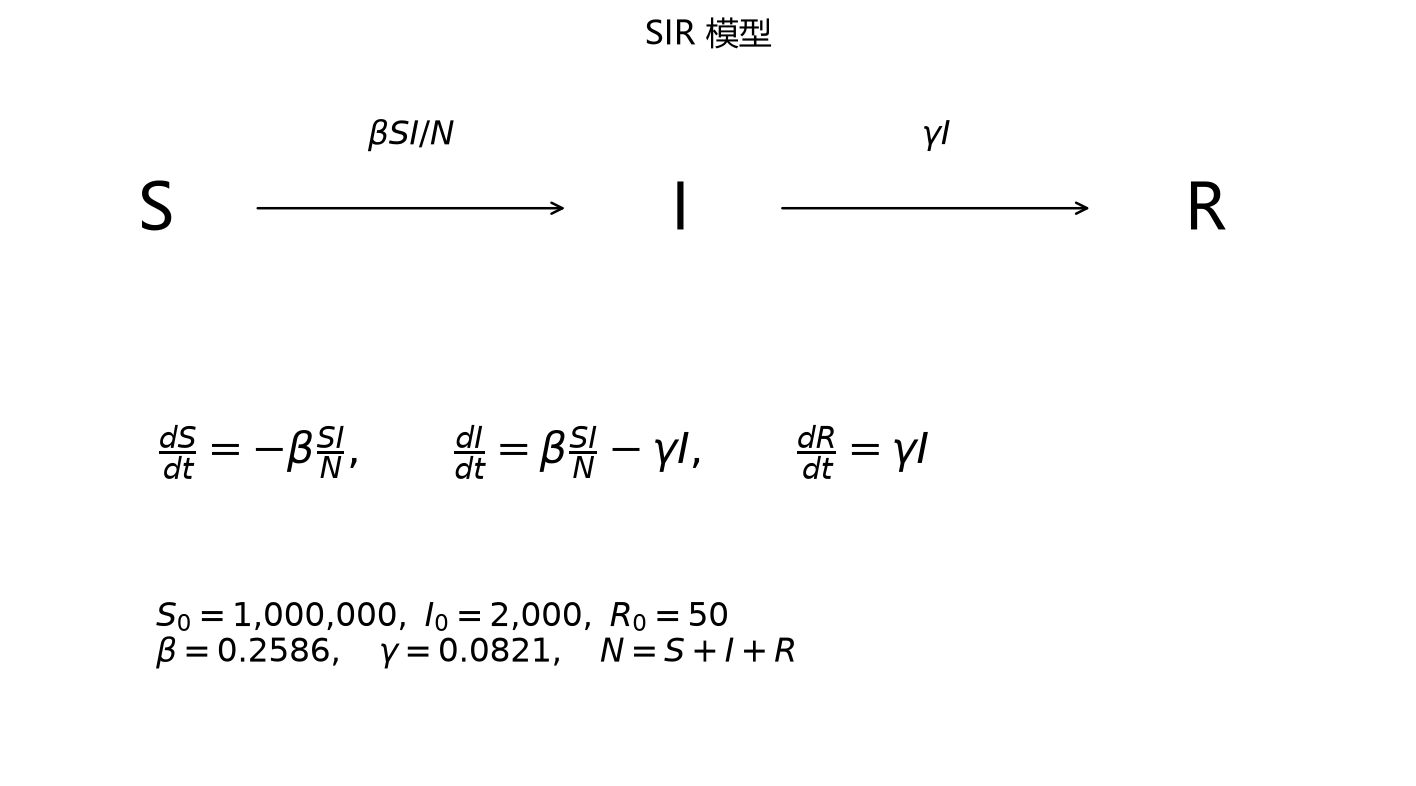
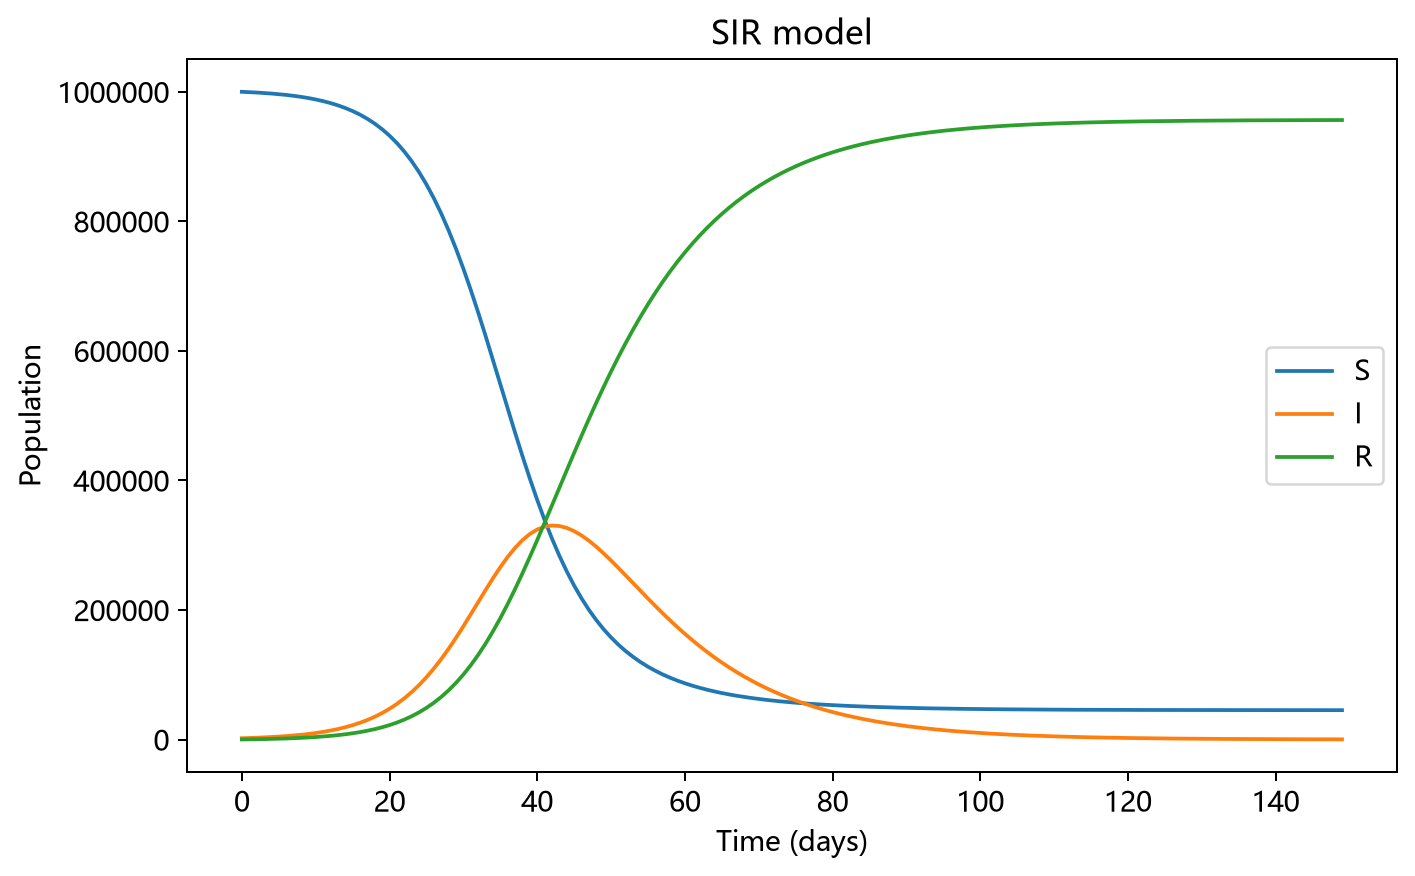
刚开始看到这个模型的时候,我是相当震惊的——居然根本不用这次疫情的数据,仅仅利用03年SARS已经有的模型参数就可以做到初期发展基本吻合,还可以预测疫情的发展趋势。便想了解一下这个模型。看了看百度百科,觉得虽说分析和解析解比较难求,但是一次次的迭代,求出数值解,画出上面类似的图像还是挺简单的,便想着自己用python实现一下。
公式刚开始的时候是用的百度百科中的,可是画出来的图形就是特别怪异,再三检测代码后觉得代码应该是没有问题的,再看了看上的图,觉得应该是出自一个可以动态作图的网页,便通过图中的关键词”Hans Nesse - Gobal Health - SIR Model“,一下就搜出来了对应的画图网站:http://www.public.asu.edu/~hnesse/classes/sir.html. 并且下面还有微分方程的介绍,对比了一下百度百科中的微分方程,发现原来百度百科把I*S/ N下面的N给弄掉了,代码改正后,输入和于教授相同的初始参数,代码终于跑通了。代码及结果如下。
# 导入相关包
import numpy as np
import matplotlib.pyplot as plt

# 初始化参数
# 易感人群数量
S_0 = 0

# 初始感染数量
I_0 = 0

# 治愈和死亡数量
R_0 = 0

# 传染率beta
beta = 0

# 康复和死亡率
gamma = 0

# 德教授于晓华的参数
S_0 = 1000000
I_0 = 2000
R_0 = 50
beta = 0.2586
gamma = 0.0821

N = I_0 + S_0 + R_0


# 计算导数
def de_S(I, S):
    return -beta * I * S / N


def de_I(I, S):
    return beta * I * S / N - gamma * I


def de_R(I):
    return gamma * I


# 计算days天内的三种人数的数据

days = 150
X = np.arange(0, days)
# print(X)
I_t = np.zeros(days)
S_t = np.zeros(days)
R_t = np.zeros(days)

# 初始化
I_t[0] = I_0
S_t[0] = S_0
R_t[0] = R_0

for i in range(1, days):
    d_I = de_I(I_t[i - 1], S_t[i - 1])
    d_S = de_S(I_t[i - 1], S_t[i - 1])
    d_R = de_R(I_t[i - 1])
    I_t[i] = I_t[i - 1] + d_I
    S_t[i] = S_t[i - 1] + d_S
    R_t[i] = R_t[i - 1] + d_R


# 绘图
def plot():
    plt.plot(X, S_t, 'r--', X, I_t, 'b--', X, R_t, 'g--')
    plt.show()


plot()
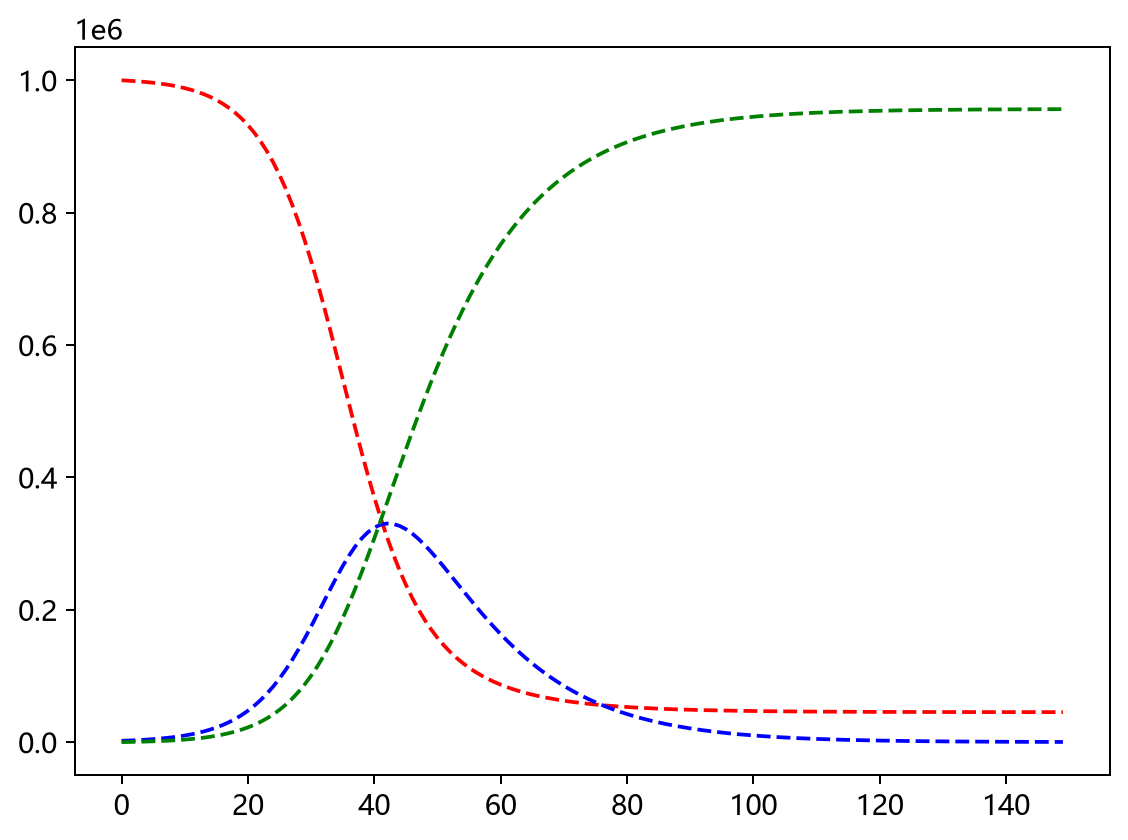
SIR模型是传染病模型中一个基本模型,即在一个封闭的环境(S+I+R为常数)中,S为易感人群,I为感染者,R为康复者,S 与I接触则有一定比例会变为I, I中有一定比例会变为R.S,I,R不断动态变化直到稳定。
SIR没有任何关于疫情其它信息的利用,人口,地理信息,初期的疫情数据,隔离等措施。所有的影响都将反映在感染率beta, 移除率gamma上(应该会有利用疫情的早期数据估计初始参数的方法,这一点我还没有深入。)加上于教授用的就是SARS的数据。 而这次的疫情和SARS不太一样,一是潜伏期还可以传染而且发生在武汉春运期间,二是整个国家采取的应对措施不同。还有一点就是当S初始值设为100万时,I的最大值为30万左右。当然最重要的是模型过于简单。所以我觉得这个SIR模型不太可信。
指数拟合模型
上面的两个模型都没有用到最新的,最核心的数据那就是国内每天报告的累计确诊总数。我认为,可以用种群中的”J”型曲线,“S”型曲线来拟合。在新型冠状病毒爆发的早期,以接近指数的方式增长,也就是”J”型曲线,这个时候可以通过指数函数来拟合,但随着各种防控措施的生效(主要是隔离),病毒的环境容纳量被限制住,确诊人数的增长会放缓,最终被限制住,然后确诊的人被治愈或是死亡那,最终疫情结束。
这个主要采用1月11日到1月26日的数据(来自wikipedia),因为这一段时间的数据是连续的,前面日期的数据不但断断续续,而且还忽高忽低。还有就是通过新增累计的和确诊的病例和最后累计的数并不相当。由于相差不大,这里也不做深入探究。拟合曲线即结果如下:
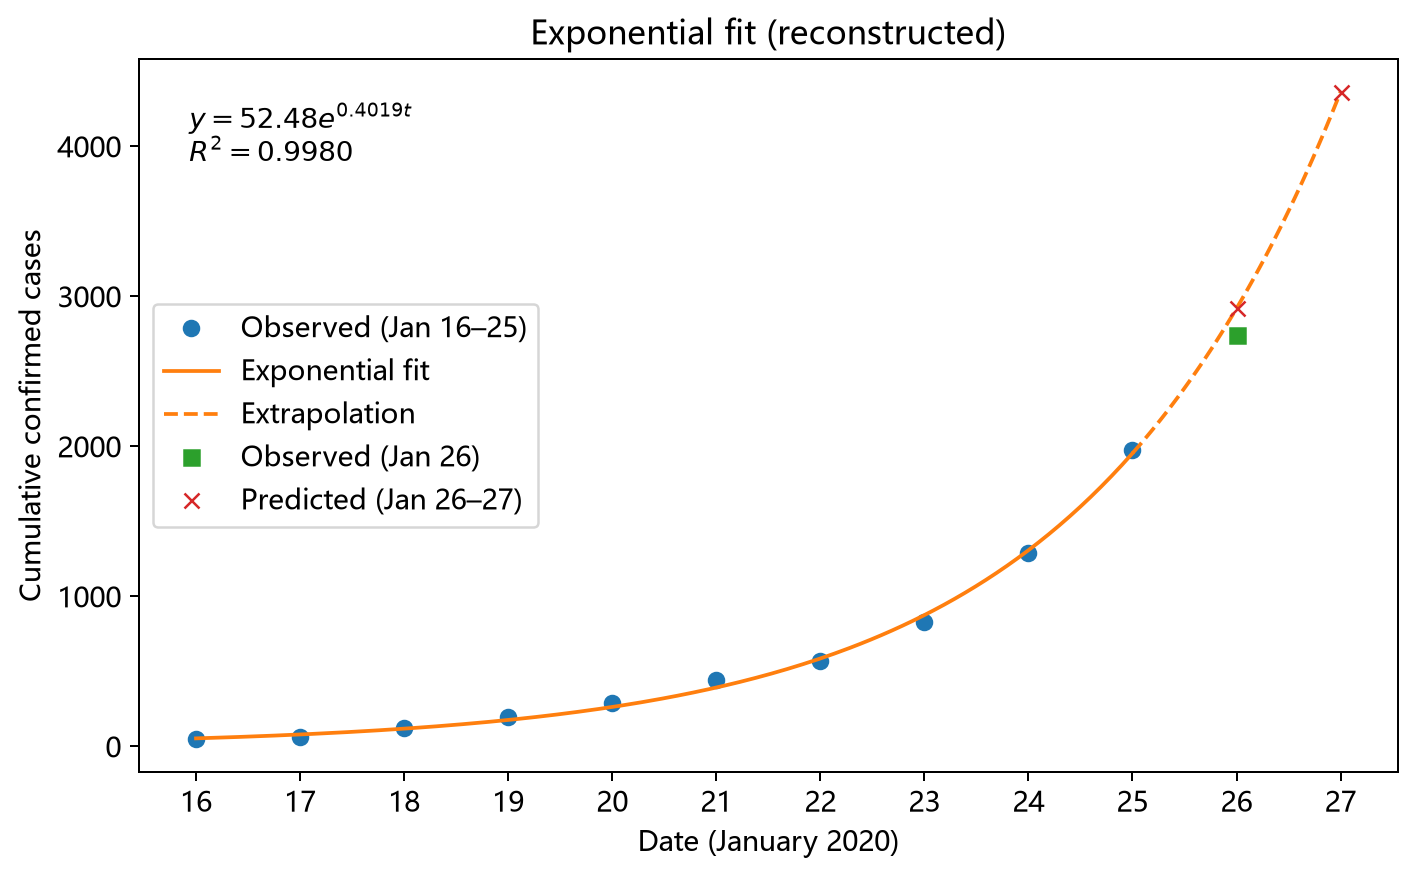
这里用1月16日到1月25日的数据作拟合,预测1月26日的病例数和1月27日的病例数。拟合曲线的R平方为0.99,说明拟合得相当得好,虽然不能说明这个趋势将一直持续下去,至少可以说明疫情正处于早期爆发阶段。正在以指数形式增长。而预测的1月26日的情况,结果的误差约为11%,已经有点大了。未来如何变化,还是等待更多的数据出来吧。