利用 VS Code 搭建 Paddle Fluid 开发环境
目录
下载vscode
在ubuntu环境下,登录vs code 的官⽹[https://code.visualstudio.com/],下载deb包,安装即可。
查看系统python版本
$python --version
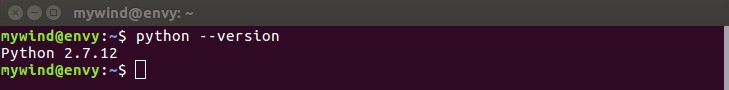
笔者使⽤的是ubuntu16.04, 系统的python的默认版本是2.7,但2.7版本即将停⽌维护,推荐使⽤python3.先安装
python3
$ sudo apt-get install python3
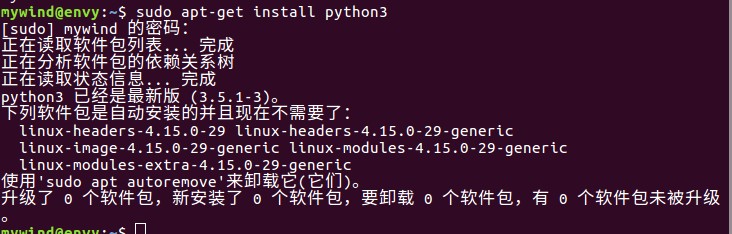
检查是否安装成功
$python3 --version

下载 paddle.fluid
对应python3 ,⽤pip3安装:pip3 install paddlepaddle[CPU版本],pip install paddlepaddle-gpu (GPU版本 最新)。(GPU版本先要安装好cuda 和cudnn)[注意直接安装最后会报权限不够的错误]

这个问题可以通过sudo 安装的⽅式避免(需要输⼊ 密码):[或者通过su -切换到 root ⽤⼾下安装;或者加 --user选
项]
$sudo pip3 install paddlepaddle
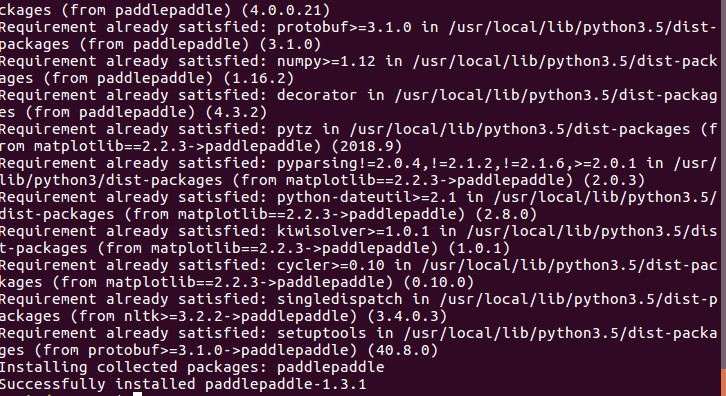
由于系统默认的python是2.7版本的,如果直接导⼊paddle模块,就会报以下错误。
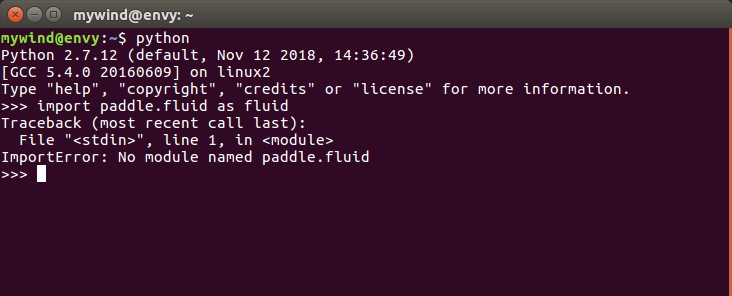
所以需要将系统的默认python环境配置为python3,可以通过下⾯的命令修改python的默认版本
$  sudo update-alternatives  --install  /usr/bin/python  python  /usr/bin/python2  100
$  sudo update-alternatives  --install  /usr/bin/python  python  /usr/bin/python3  150
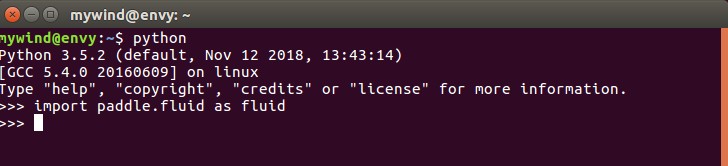
再查看python的默认版本,发现已经切换为Python3.

注:今后如果想将Python命令指向默认的的版本,通过‘sudo update-alternatives --config python'命令即可实现切
换。
再次引⼊paddle模块,发现已经可以成功引⼊。
⼈⼯智能知识⼊⻔,
本章由6篇文档组成,它们按照简单到难的顺序排列,将指导您如何使用PaddlePaddle完成基础的深度学习任务
本章文档涉及大量了深度学习基础知识,也介绍了如何使用PaddlePaddle实现这些内容,请参阅以下说明了解如何使用:
内容简介
使用方法
创建一个文件夹用来放源码
$mkdir mypaddle
将实例代码clone 到本地(需要安装 git)
$git clone https://github.com/PaddlePaddle/book.git
从vs code 中打开文件夹。
选择对应文件(比如:02.recongnize_digits中的train.py.)[建议先看一下readme文件,大致了解一下程序的原理] ,运行代码:CTRL + Alt + N (或者提前安装code Runner 插件,然后点右上角的三角形即可)
下面的是示例程序中要识别的数字:
最后程序运行结束后,我们可以看到程序给出的判断结果:
相关的代码解释在README.cn.md文件中:
大家可以结合代码和readme文件慢慢上手。
注:官方推荐是使用juypter运行的,其实使用vs code运行问题也不大
相关的理论知识推荐大家参考:
学霸笔记:吴恩达老师的机器学习课程个人笔记
深度学习:Coursera深度学习教程
学霸笔记:deeplearning.ai(吴恩达老师的深度学习课程笔记及资源)
还有一个paddle应用的实例代码包也推荐大家用来学习参考:我的PaddlePaddle学习之路
代码实例
至此,您已经对Fluid核心概念有了初步认识了,不妨尝试配置一个简单的网络吧。如果感兴趣的话可以跟随本部分,完成一个非常简单的数据预测。已经掌握这部分内容的话,可以跳过本节阅读What's next。
从逻辑层面明确了输入数据格式、模型结构、损失函数以及优化算法后,需要使用 PaddlePaddle 提供的 API 及算子来实现模型逻辑。一个典型的模型主要包含4个部分,分别是:输入数据格式定义,模型前向计算逻辑,损失函数以及优化算法。
问题描述
给定一组数据 <X,Y><X,Y>,求解出函数 ff,使得 y=f(x)y=f(x),其中XX,YY均为一维张量。最终网络可以依据输入xx,准确预测出y_predicty_predict。
定义数据
假设输入数据X=[1 2 3 4],Y=[2,4,6,8],在网络中定义:
#定义X数值
train_data=numpy.array([[1.0],[2.0],[3.0],[4.0]]).astype('float32')
#定义期望预测的真实值y_true
y_true = numpy.array([[2.0],[4.0],[6.0],[8.0]]).astype('float32')
搭建网络(定义前向计算逻辑)
接下来需要定义预测值与输入的关系,本次使用一个简单的线性回归函数进行预测:
#定义输入数据类型
x = fluid.layers.data(name="x",shape=[1],dtype='float32')
#搭建全连接网络
y_predict = fluid.layers.fc(input=x,size=1,act=None)
这样的网络就可以进行预测了,虽然输出结果只是一组随机数,离预期结果仍相差甚远:
#加载库
import paddle.fluid as fluid
import numpy
#定义数据
train_data=numpy.array([[1.0],[2.0],[3.0],[4.0]]).astype('float32')
y_true = numpy.array([[2.0],[4.0],[6.0],[8.0]]).astype('float32')
#定义预测函数
x = fluid.layers.data(name="x",shape=[1],dtype='float32')
y_predict = fluid.layers.fc(input=x,size=1,act=None)
#参数初始化
cpu = fluid.core.CPUPlace()
exe = fluid.Executor(cpu)
exe.run(fluid.default_startup_program())
#开始训练
outs = exe.run(
    feed={'x':train_data},
    fetch_list=[y_predict.name])
#观察结果
print(outs)
输出结果:
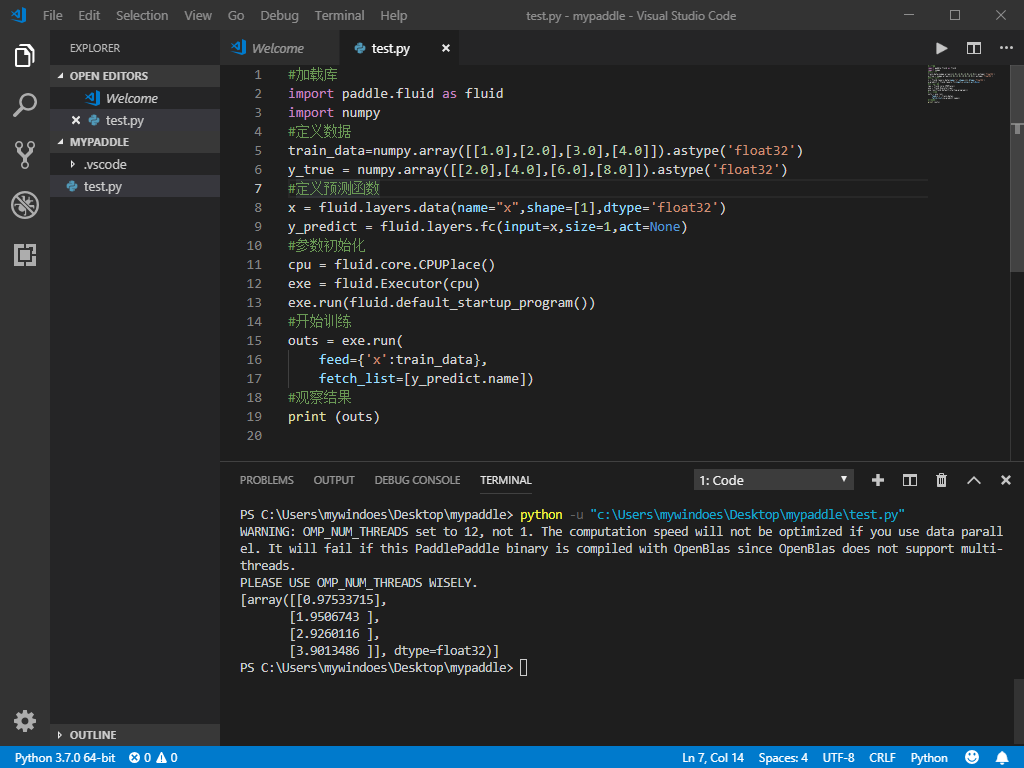
注:有一个WARNING,初学时不必在意,不影响程序正常运行
添加损失函数
完成模型搭建后,如何评估预测结果的好坏呢?我们通常在设计的网络中添加损失函数,以计算真实值与预测值的差。
在本例中,损失函数采用均方差函数:
cost = fluid.layers.square_error_cost(input=y_predict, label=y)
avg_cost = fluid.layers.mean(cost)
输出一轮计算后的预测值和损失函数:
#加载库
import paddle.fluid as fluid
import numpy
#定义数据
train_data=numpy.array([[1.0],[2.0],[3.0],[4.0]]).astype('float32')
y_true = numpy.array([[2.0],[4.0],[6.0],[8.0]]).astype('float32')
#定义网络
x = fluid.layers.data(name="x",shape=[1],dtype='float32')
y = fluid.layers.data(name="y",shape=[1],dtype='float32')
y_predict = fluid.layers.fc(input=x,size=1,act=None)
#定义损失函数
cost = fluid.layers.square_error_cost(input=y_predict,label=y)
avg_cost = fluid.layers.mean(cost)
#参数初始化
cpu = fluid.core.CPUPlace()
exe = fluid.Executor(cpu)
exe.run(fluid.default_startup_program())
#开始训练
outs = exe.run(
    feed={'x':train_data,'y':y_true},
    fetch_list=[y_predict.name,avg_cost.name])
#观察结果
print(outs)
输出结果:
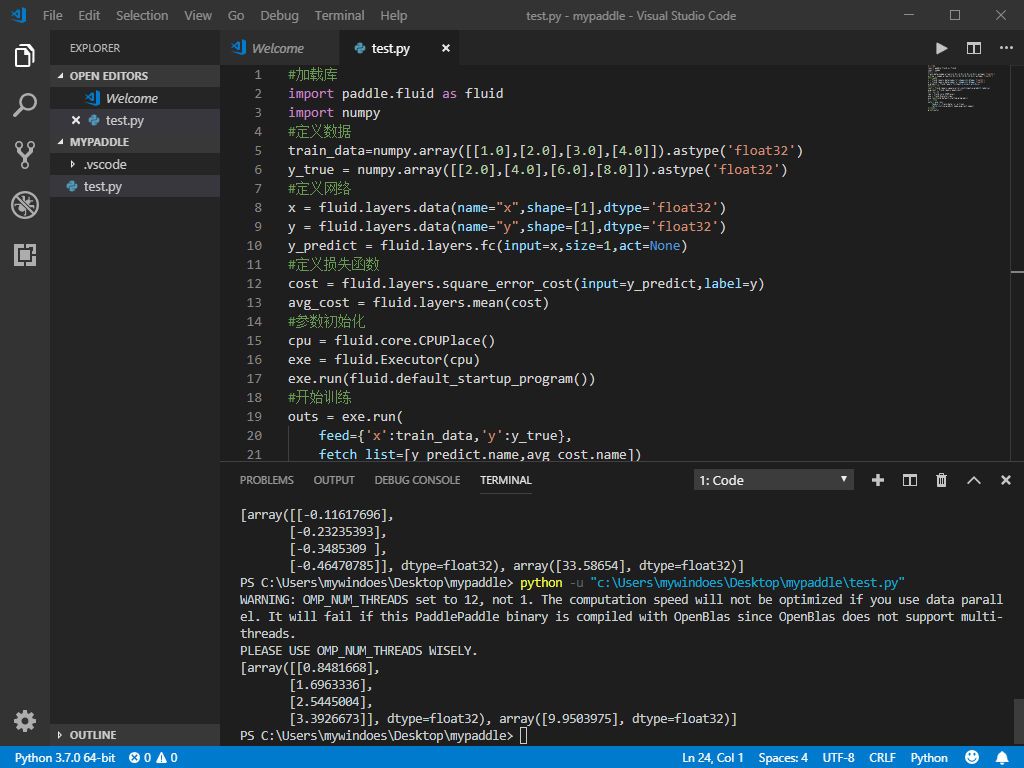
可以看到第一轮计算后的损失函数为9.95,仍有很大的下降空间。由于并没有对损失函数优化,而且只迭代了一次,每个人运行得到的损失函数的值差异会很大。
网络优化
确定损失函数后,可以通过前向计算得到损失值,然后通过链式求导法则得到参数的梯度值。
获取梯度值后需要更新参数,最简单的算法是随机梯度下降法:w=w−η⋅g,由fluid.optimizer.SGD实现:
sgd_optimizer = fluid.optimizer.SGD(learning_rate=0.01)
让我们的网络训练100次,查看结果:
#加载库
import paddle.fluid as fluid
import numpy
#定义数据
train_data=numpy.array([[1.0],[2.0],[3.0],[4.0]]).astype('float32')
y_true = numpy.array([[2.0],[4.0],[6.0],[8.0]]).astype('float32')
#定义网络
x = fluid.layers.data(name="x",shape=[1],dtype='float32')
y = fluid.layers.data(name="y",shape=[1],dtype='float32')
y_predict = fluid.layers.fc(input=x,size=1,act=None)
#定义损失函数
cost = fluid.layers.square_error_cost(input=y_predict,label=y)
avg_cost = fluid.layers.mean(cost)
#定义优化方法
sgd_optimizer = fluid.optimizer.SGD(learning_rate=0.01)
sgd_optimizer.minimize(avg_cost)
#参数初始化
cpu = fluid.core.CPUPlace()
exe = fluid.Executor(cpu)
exe.run(fluid.default_startup_program())
##开始训练,迭代100次
for i in range(100):
    outs = exe.run(
        feed={'x':train_data,'y':y_true},
        fetch_list=[y_predict.name,avg_cost.name])
#观察结果
print(outs)
输出结果:
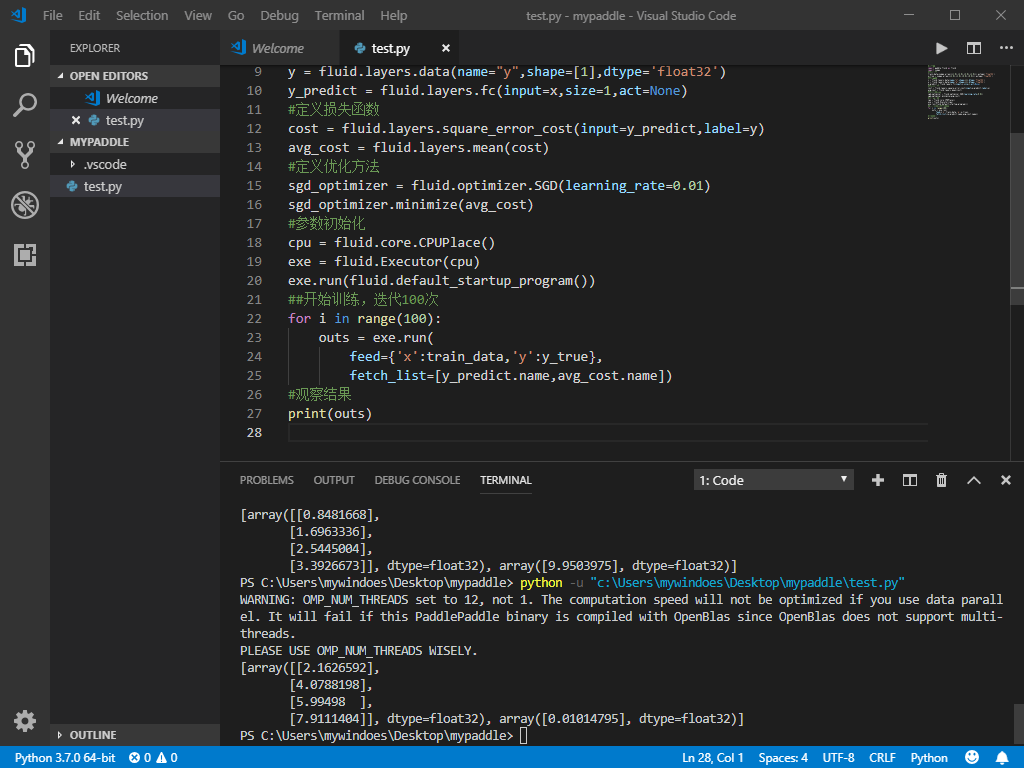
可以看到100次迭代后,预测值已经非常接近真实值了,损失值也从初始值9.95下降到了0.01。
恭喜您!已经成功完成了第一个简单网络的搭建,想尝试线性回归的进阶版——房价预测模型,请阅读:线性回归。更多丰富的模型实例可以在模型库中找到。
What's next
如果您已经掌握了基本操作,可以进行下一阶段的学习了:
跟随这一教程将学习到如何对实际问题建模并使用fluid构建模型:配置简单的网络。
完成网络搭建后,可以开始在单机或多机上训练您的网络了,详细步骤请参考训练神经网络。
除此之外,使用文档模块根据开发者的不同背景划分了三个学习阶段:新手入门、使用指南和进阶使用。
如果您希望阅读更多场景下的应用案例,可以跟随导航栏进入快速入门和深度学习基础知识。已经具备深度学习基础知识的用户,可以从使用指南开始阅读。